Разработка веб-приложений на заказ
Порталы, личные кабинеты, ERP/CRM и интеграции — чтобы процессы работали быстрее, а ошибки и простои не сжигали бюджет.
Системный дизайн до реализации, предсказуемая работа под нагрузкой, безопасность данных и эксплуатация без «пожаров» в пиковые часы.
Инфраструктуру и хостинг подбираем под нагрузку и бюджет.
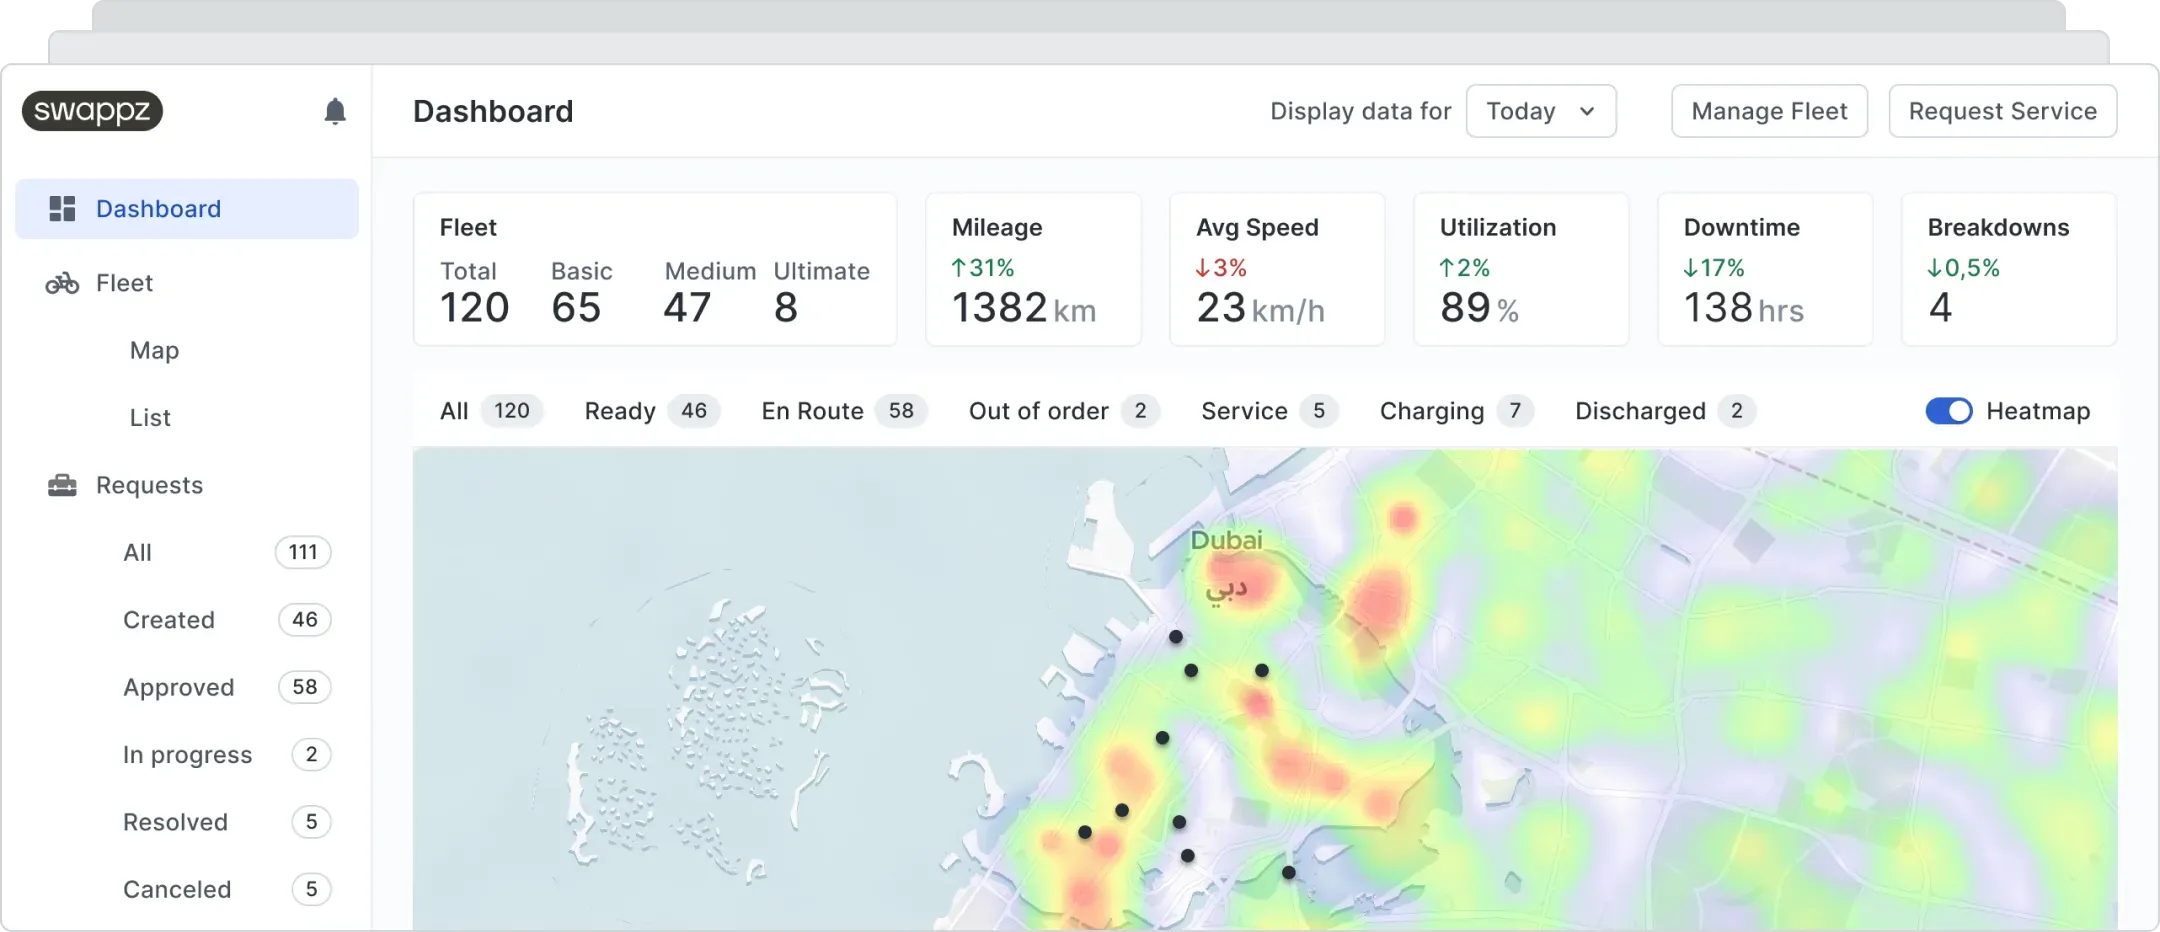
Основа для скорости интерфейса и стабильной работы под нагрузкой
Технологии подбираются под бизнес-риски: простои, потери данных, ошибки интеграций и стоимость изменений.
Laravel
Быстрые изменения в доменной логике и админ-панелях: правила, роли, статусы, документы, очереди и фоновые задачи без разрастания хаоса в коде.
Go
Сервисы для «тяжёлых» операций: интеграции, обработка потоков данных, расчёты и высокий RPS — когда задержки превращаются в очереди и срывы SLA.
Next.js
Быстрый отклик интерфейса и предсказуемая навигация в кабинетах и порталах. SSR/SEO для публичных страниц и стабильная архитектура фронтенда.
Docker
Воспроизводимые окружения: одинаковое поведение на ноутбуке, CI и продакшене. Меньше сюрпризов при релизах и откатах.
Nginx
Контроль трафика и кеширование на edge-уровне: меньше латентности, предсказуемая защита и стабильная работа при всплесках запросов.
Композиция стеков зависит от требований: монолит + сервисы, очереди, кеши, репликация и контуры окружений.
Когда такое решение уместно
Облачное веб-ПО имеет ограничения: нужен бюджет на разработку и поддержку, зависимость от сети и инфраструктуры.
Имеет смысл, когда несколько отделов работают в одной системе и нужны единые роли, журналы и отчёты.
Бюджеты до 1,5 млн ₽ и задачи без жёстких требований сторов часто закрываются веб-приложением или PWA — это отдельный контур от мобильной разработки (порог мобильного приложения — от 1,5 млн ₽ и от 3 месяцев).
Менее уместно, если критична автономная работа без сети или достаточно одного десктопного приложения без общего доступа.
Процесс, который снижает риски до релиза
- 1
Системный дизайн до разработки
Модель данных, роли, статусы и контракты интеграций фиксируются до реализации. Это снижает переделки и защищает сроки, когда в проекте появляется «ещё один обязательный сценарий».
- 2
Код без техдолга
Кодовая база остаётся расширяемой: ревью, типизация, контроль зависимостей и понятные границы модулей. Это ускоряет изменения и снижает стоимость поддержки.
- 3
Тесты до релиза
Тестируются критичные сценарии и регрессии, контракты API и узкие места под нагрузкой. Цель — меньше инцидентов и меньше «ручных операций» после релиза.
- 4
Релизы без простоев
CI/CD, контейнеры, окружения, мониторинг и алертинг. Релизы проходят управляемо: без потери данных и без «ночных включений» из-за мелких правок.
Стандарты качества
Безопасность данных
Роли и политики доступа, аудит действий, минимизация прав, защита секретов и безопасные интеграции.
Отказоустойчивость (High Availability)
Дублирование критичных компонентов, контроль деградации, бэкапы и сценарии восстановления.
Масштабирование (Horizontal Scaling)
Статус-менеджмент и архитектура, позволяющие добавлять мощности без переписывания системы: кеши, очереди, шардирование по необходимости.
Проекты, где веб-архитектура решает бизнес-риски
Примеры из портфолио: высокая нагрузка, интеграции, сложные расчёты и сценарии, где цена ошибки измеряется деньгами и SLA.


